 24:42
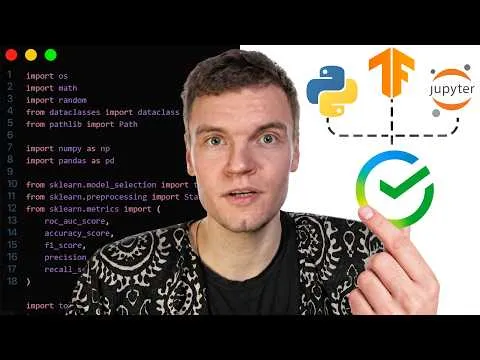
ЖЕСТКОЕ СОБЕСЕДОВАНИЕ В СБЕР на Data Scientist
Просмотры на YouTube: 21 тыс.Лайки на YouTube: 533
 Сбер

Разбор интервью Data Scientist на проект Госуслуг: классификация текстов, метрики, TF-IDF, развёртывание модели и архитектуры нейросетей.
 Госуслуги
На собеседовании по NLP кандидат обсуждает многоклассовую классификацию обращений, выбор метрик и признаки TF-IDF. Вторая часть проверяет уже инженерную сторону решения: асинхронность, сохранение модели, трансформеры и ускорение инференса.
24:42Сбер 1:02:20
 Samokat.tech
 1 ч 41 мин
 Facebook
 8:15Сбер
 10:41
 Райффайзен Банк
 32 мин